Opinies
Het verschil tussen een tomaat en Mickey Mouse
Dirk Visser
Prof. mr. D.J.G. Visser is hoogleraar IE in Leiden (d.j.g.visser@law.leidenuniv.nl) en advocaat in Amsterdam.
Als ik ChatGPT vraag om een “fotorealistische weergave van een tomaat” krijg ik het volgende resultaat: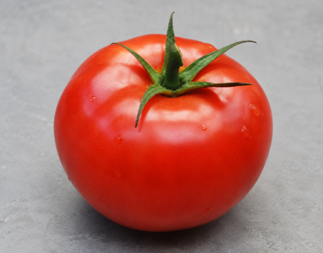
Als ik aan ChatGPT vraag om een “gedetailleerde tekening van Mickey Mouse” krijg ik het volgende resultaat:

Hieruit blijkt dat ten gevolge van de ‘guardrails’ (prompt- of outputcontrole) ChatGPT voor mij geen gedetailleerde afbeelding van Mickey Mouse maakt.
Hieruit blijkt ook dat ChatGPT het zonder deze ‘guardrails’ vermoedelijk prima zou kunnen. ChatGPT kan het wel, maar mag het niet van aanbieder OpenAI.
Het verschil tussen een tomaat en Mickey Mouse is in dit verband uiteraard dat een tomaat niet auteursrechtelijk beschermd is en Mickey Mouse wel.
Voor een AI-model is dat in technisch opzicht geen relevant verschil. Voor een AI-model is een tomaat een object dat zich zo vaak in zijn trainingsdata bevindt dat hij de kenmerken ervan heel goed kent en kan reproduceren. Maar Mickey Mouse is dat evenzeer (wereldberoemde cartoon van een muis met grote ronde zwarte oren witte handschoenen en gele schoenen). Ook Mickey Mouse komt talloze malen voor de in de trainingsdata van het AI-model. Daarom kent het AI-model de kenmerken ervan heel goed en kan ze feilloos reproduceren.
Bij de tomaat is iedereen tevreden en onder de indruk van het prachtige resultaat.
Maar als ChatGPT een perfecte Mickey Mouse zou tekenen zou dat een kopie (reproductie) van een auteursrechtelijk beschermd werk opleveren. Daarmee is mogelijk sprake van auteursrechtinbreuk, waar OpenAI mogelijk medeaansprakelijk voor zou zijn.
Het feit dat ChatGPT in staat is om een perfecte Mickey Mouse te maken, kan als bewijs dienen voor de stelling dat ChatGPT Mickey Mouse heeft ‘gememoriseerd’. ‘Memorisatie’ is een term die gebruikt wordt om te betogen dat auteursrechtelijk beschermd werk in AI-modellen is ‘opgeslagen’ en daarmee in dat model auteursrechtelijk relevant is ‘gereproduceerd’.
Over deze kwalificatie bestaat momenteel veel discussie. De Rechtbank in München heeft inmiddels in twee vonnissen geoordeeld dat output die sterke gelijkenis vertoont met auteursrechtelijk beschermd werk zelf inbreukmakend is, bewijs vormt van auteursrechtelijk relevante ‘memorisatie’ in het AI-model en ertoe leidt dat ook de training van het AI-model als inbreukmakend moet worden gekwalificeerd, waar de aanbieder van het AI-model aansprakelijk voor is.
Tegenstanders van deze zienswijze zeggen dat van ‘memorisatie’ geen sprake is of dat deze niet auteursrechtelijk relevant is. Ook zeggen zij vaak dat dit verschijnsel niet de bedoeling is van AI-modellen, bij normaal gebruik niet of nauwelijks voorkomt en eigenlijk altijd het gevolg is van opzettelijk, herhaald en/of manipulatief prompten, waardoor de aanbieder van het AI-model er niet aansprakelijk voor kan worden gehouden. Te veel op bestaand beschermd werk gelijkende output en ‘memorisatie’ zou ook voorkomen kunnen worden door de trainingsdata zorgvuldig te ‘ontdubbelen’. Als er niet te veel Mickey Mousen, Harry Potter-boeken of liedjes van The Beatles in de trainingsdata zouden zitten, of die er eerst uitgehaald zouden worden, dan zou er helemaal geen ‘memorisatie’ of te veel gelijkende output kunnen ontstaan. Het zou gaan om onwenselijke en tijdelijke ‘overrepresentatie’ van bepaalde bekende werken in de trainingsdata. Het wordt gepresenteerd als een kinderziekte en een oplosbaar probleem.
Daarbij wordt als gezegd benadrukt dat het helemaal niet de bedoeling van AI-modellen is om bestaande werken te reproduceren en gevallen van ‘memorisatie’ eigenlijk ‘bedrijfsongevalletjes’ zijn die zich bij steeds betere AI-modellen niet of nauwelijks meer zullen voordoen. Als we zouden zeggen dat de vorm van een tomaat beschermd is, dan halen we gewoon alle tomaten uit de trainingsdata en zetten we een tomaten-filter op de output.
Deze redenering overtuigt mij niet. Vanuit de werking van een AI-model verschilt Mickey Mouse niet van een tomaat. En dat geldt ook voor Harry Potter-boeken en liedjes van The Beatles. Als ze veel voorkomen in de trainingsdata, zullen AI-modellen ze desgevraagd tamelijk nauwkeurig kunnen reproduceren. En hoe beter het AI-model, hoe beter het AI-model ook dat kan.
De prompt “gedetailleerde tekening van Mickey Mouse” was wel opzettelijk, maar (in eerste instantie) niet herhaald of manipulatief. Mijn poging om het doel van mijn verzoek (rechtmatig citeren) erbij te betrekken, was wel manipulatief, maar alleen ten aanzien van het output-filter.
Los van het auteursrecht kan het perfecte AI-model in de toekomst alles wat er al is feilloos reproduceren én onbeperkt varianten daarop maken én nieuwe content genereren. Via ‘guardrails’ (prompt- of outputcontrole) kan geprobeerd worden om bepaalde output tegen te houden, zoals ook ander ongewenste (racistische, terroristische, tot suïcide aanzettende) output wordt tegengehouden.
De stelling dat sterk gelijkende output bij Mickey Mouse een freak accident is terwijl sterk gelijkende output bij tomaten een bewijs is dat het AI-model juist heel goed doet waar het voor bedoeld is, wil er bij mij dan ook niet in.
Het echte probleem is en blijft dat de output van AI-modellen in de ogen van velen oneerlijk concurreert met het auteursrechtelijke beschermde werk waarop het zonder toestemming of vergoeding is getraind. Dat probleem los je met een output-filter niet op.
Overigens heeft The Walt Disney Company in December 2025 een deal gesloten met OpenAI waarbij Disney een miljard dollar investeert in OpenAI en licenties verstrekt waarbij gebruikers het recht krijgen om binnen het Sora videoplatform van OpenAI meer dan 200 Disney karakters te gebruiken.[1]
Voor kleine, Europese rechthebbenden lijkt een dergelijke oplossing nog ver weg. Als ik ChatGPT vraag “maak een tekening van Pluk van de Petteflet” krijg ik dit resultaat:

Misschien lijkt Pluk te veel op een tomaat.
Auteur(s)
Advocaat sinds 1996. Focus op auteursrecht, databankenrecht, merken- en modellenrecht, portretrecht en de naburige rechten, regulering en aansprakelijkheid online platforms. Hoogleraar intellectueel eigendomsrecht aan de Universiteit Leiden.
AI-forum 2026/3
Openbaar is niet vogelvrij: nieuwe EDPB-richtlijnen over webscraping voor generatieve AI onder de AVG
Voor de ontwikkeling van generatieve AI zijn grote hoeveelheden data nodig. Veel AI-ontwikkelaars verzamelen die data door middel van webscraping: het geautomatiseerd ophalen van informatie van het openbare internet. Gescrapete bronnen bevatten ni...
Eerste Nederlandse advocaat berispt wegens onzorgvuldig AI-gebruik
De Nederlandse tuchtrechter heeft voor het eerst een advocaat berispt vanwege onzorgvuldig gebruik van AI. De advocaat had in twee huurprocedures door AI gegenereerde rechtspraak opgenomen zonder de uitspraken te lezen of de verwijzingen te contro...
Filteren zonder beslissing: AI-uploadfilters en de grenzen van artikel 10 EVRM
Een gebruiker plaatst een bericht op een platform en klikt op publiceren. Het bericht verschijnt niet. Er verschijnt geen melding, geen reden en geen beslissing. De uiting is geblokkeerd voordat zij de publieke ruimte heeft bereikt. Artikel 10 EVR...
Definitieve richtsnoeren artikel 50 AI-verordening (transparantie): dit zijn de 9 belangrijkste wijzigingen
Op 20 juli 2026 heeft de Europese Commissie de definitieve richtsnoeren over de transparantieverplichtingen van artikel 50 AI-verordening gepubliceerd. Deze verplichtingen zijn vanaf 2 augustus 2026 van toepassing op aanbieders en gebruiksverantwo...
Rechtbank Frankfurt verduidelijkt wanneer AI-afbeeldingen auteursrechtinbreuk opleveren
Generatieve AI maakt het eenvoudig om bestaande foto's als uitgangspunt te nemen voor nieuwe afbeeldingen. Daarmee rijst een fundamentele vraag: wanneer levert een met AI gegenereerde afbeelding een auteursrechtelijke bewerking van de oorspronkeli...
Rechter-commissaris: gebruik van ChatGPT kan verschoningsrecht doorbreken
Voor het eerst heeft een Nederlandse rechter zich expliciet uitgelaten over de gevolgen van het gebruik van generatieve AI voor het verschoningsrecht, oftewel het recht van (juridische) professionals om te zwijgen over het vertrouwelijke contact m...
Advocaten steeds vaker én harder bestraft voor verkeerd gebruik van AI (in binnen- en buitenland)
Generatieve AI heeft een vaste plek veroverd in de juridische praktijk. Advocaten gebruiken AI-tools om onderzoek te doen, documenten te analyseren en processtukken op te stellen. Maar met het toenemende gebruik groeit ook het aantal gevallen waar...
Therapie met ChatGPT: beschermt de AI-verordening psychisch kwetsbare gebruikers?
Generatieve AI-chatbots worden steeds vaker gebruikt als digitale gesprekspartner of zelfhulpmiddel bij psychische klachten. Voor psychisch kwetsbare gebruikers kan die laagdrempelige beschikbaarheid steun bieden, maar zij brengt ook risico’s mee,...
Kan AI het auteursrecht juist redden? Een nieuwe visie op licenties in het AI-tijdperk
Mogen ontwikkelaars van generatieve AI auteursrechtelijk beschermde werken gebruiken voor de training van hun modellen? En zo ja, onder welke voorwaarden? De discussie wordt al langere tijd gevoerd, maar juridische duidelijkheid laat nog op zich w...
Amerikaans hof komt tot ongemakkelijk oordeel: bezit van AI-gegenereerde kinderporno is niet strafbaar
Een Amerikaans hof heeft geoordeeld dat het enkele bezit in de eigen woning van volledig AI-gegenereerd materiaal van seksueel kindermisbruik naar huidig Amerikaans recht niet strafbaar kan worden gesteld. Daarbij is doorslaggevend dat de beelden ...